A ACP (Capítulo 4) olha para um único conjunto de variáveis e procura as direções em que ele mais varia. Muitas perguntas, porém, envolvem dois conjuntos. Um médico mede a pressão, o colesterol e a glicemia de seus pacientes e quer saber como esses exames se relacionam com horas de sono, consumo de álcool e atividade física. Um biólogo mede o bico e o corpo de pinguins e quer saber como o formato de um acompanha o tamanho do outro.
Com uma variável de cada lado, bastaria calcular uma correlação. Com várias variáveis de cada lado, são muitas correlações cruzadas, e fica difícil enxergar o padrão numa tabela desse tamanho. A análise de correlação canônica (ACC), proposta por Harold Hotelling nos anos 1930, resume essa tabela procurando uma combinação linear de cada conjunto de modo que as duas combinações sejam o mais correlacionadas possível. Em seguida procura um segundo par, não correlacionado com o primeiro, e assim por diante. Os pares encontrados são as variáveis canônicas, e as correlações dentro de cada par, as correlações canônicas.
Os dois conjuntos entram na análise do mesmo jeito. Nenhum deles faz o papel de resposta, como numa regressão, embora nada impeça que, na hora de interpretar, um deles seja lido como explicação do outro.
7.1 Correlações canônicas
Vamos dividir o vetor aleatório \(\boldsymbol{x}\) em dois blocos, o primeiro com \(p\) variáveis e o segundo com \(q\), chamando de primeiro o bloco menor, de modo que \(p \le q\). A matriz de covariâncias se divide da mesma forma,
Os blocos da diagonal são as matrizes de covariâncias de cada conjunto, e \(\boldsymbol{\Sigma}_{12}\) reúne as covariâncias entre variáveis de conjuntos diferentes. Vamos supor \(\boldsymbol{\Sigma}\) positiva-definida, o que garante que os blocos da diagonal sejam inversíveis. Para uma combinação linear de cada bloco,
\[
U = \boldsymbol{a}^T\boldsymbol{x}^{(1)},
\qquad
V = \boldsymbol{b}^T\boldsymbol{x}^{(2)}
\]
Multiplicar \(\boldsymbol{a}\) ou \(\boldsymbol{b}\) por uma constante positiva não muda a correlação entre as duas combinações, então podemos fixar a escala exigindo variância 1 para ambas. Com essa escolha, a correlação é a própria covariância.
Definição 7.1 (Correlações canônicas) As variáveis canônicas são pares de combinações lineares \((U_1, V_1), \dots, (U_p, V_p)\), todas com variância 1, em que \(U_k\) vem do primeiro bloco e \(V_k\) do segundo. O primeiro par é o de maior correlação possível, e cada par seguinte é o de maior correlação entre as combinações que não se correlacionam com as variáveis canônicas anteriores do mesmo bloco. São \(p\) pares porque o primeiro bloco só comporta \(p\) combinações não correlacionadas entre si. As correlações dentro de cada par, \(\rho_1 \ge \rho_2 \ge \dots \ge \rho_p\), são as correlações canônicas.
Para encontrar o primeiro par, maximizamos a covariância entre as duas combinações com a restrição de variância 1,
Multiplicando a primeira equação à esquerda por \(\boldsymbol{a}^T\) e a segunda por \(\boldsymbol{b}^T\) e usando as restrições, os dois multiplicadores são iguais à própria correlação entre as combinações,
Assim como na ACP, a solução é uma equação de autovalores. O vetor \(\boldsymbol{a}\) é um autovetor da matriz \(\boldsymbol{\Sigma}_{11}^{-1}\boldsymbol{\Sigma}_{12}\boldsymbol{\Sigma}_{22}^{-1}\boldsymbol{\Sigma}_{21}\), e o quadrado da correlação é o autovalor correspondente. Para maximizar a correlação, escolhemos o maior autovalor, \(\rho_1^2\), e um autovetor \(\boldsymbol{a}_1\) associado, reescalado para que \(U_1\) tenha variância 1. O coeficiente do outro bloco sai da segunda equação de Equação 7.1,
Os pares seguintes saem da mesma equação. Repetindo a maximização com as restrições de não correlação, o \(k\)-ésimo par corresponde ao \(k\)-ésimo maior autovalor, e a \(k\)-ésima correlação canônica é a raiz dele. As variáveis canônicas obtidas assim também não se correlacionam com as parceiras dos outros pares, isto é, \(U_k\) e \(V_l\) são não correlacionadas sempre que \(k \neq l\). Cada variável canônica só se correlaciona com a sua parceira, e a associação entre os blocos fica organizada em pares que não se misturam.
Nota
A matriz da Equação 7.2 não é simétrica, e por isso os programas costumam seguir outro caminho, que chega à mesma solução. Eles branqueiam cada bloco com a inversa da raiz quadrada da Definição 2.13 e fazem a decomposição em valores singulares (Definição 2.14) da matriz
Os valores singulares de \(\boldsymbol{K}\) são as correlações canônicas, e os vetores singulares, multiplicados por \(\boldsymbol{\Sigma}_{11}^{-1/2}\) e \(\boldsymbol{\Sigma}_{22}^{-1/2}\), dão os coeficientes. É esse o caminho do código no Exemplo 7.4.
As correlações canônicas também não mudam quando reescalamos as variáveis, nem, de forma mais geral, quando cada bloco passa por uma transformação linear inversível (Exercício 7.2). Por isso é comum trabalhar com variáveis padronizadas, usando a matriz de correlações \(\boldsymbol{\rho}\) no lugar de \(\boldsymbol{\Sigma}\). Os coeficientes mudam de escala, mas as correlações e as próprias variáveis canônicas continuam as mesmas.
Exemplo 7.1 (Medidas da cabeça de irmãos) No começo do século XX, antropólogos mediram o comprimento e a largura da cabeça do primeiro e do segundo filho de várias famílias para estudar o quanto irmãos se parecem. Vamos usar uma versão simplificada desse estudo, com as quatro medidas padronizadas. O primeiro bloco traz o comprimento e a largura da cabeça do primeiro filho, e o segundo, as mesmas medidas do segundo filho, nessa ordem. A matriz de correlações é
Dentro de cada filho, comprimento e largura têm correlação 0.60. Entre irmãos, a mesma medida tem correlação 0.65, e medidas trocadas, 0.55. Por enquanto, vamos tratar essas correlações como conhecidas.
Os três blocos da matriz têm a mesma forma, com os dois elementos da diagonal iguais e os dois de fora também, e por isso compartilham os autovetores
Em cada bloco, o autovalor ligado a \(\boldsymbol{e}_1\) é a soma dos dois elementos distintos, e o ligado a \(\boldsymbol{e}_2\) é a diferença. Os blocos da diagonal têm autovalores 1.6 e 0.4, e o bloco cruzado, 1.2 e 0.1. Como todos se decompõem na mesma base, a matriz da Equação 7.2 também tem autovetores \(\boldsymbol{e}_1\) e \(\boldsymbol{e}_2\), e seus autovalores saem multiplicando e dividindo os autovalores dos blocos,
As correlações canônicas são 0.75 e 0.25. Os coeficientes são os autovetores reescalados para dar variância 1, e como as combinações definidas por \(\boldsymbol{e}_1\) e \(\boldsymbol{e}_2\) têm variâncias 1.6 e 0.4,
Pela Equação 7.1, os coeficientes do segundo filho são os mesmos, como se espera da simetria entre os irmãos. O primeiro par soma as duas medidas e mede o tamanho da cabeça de cada filho. O segundo subtrai uma da outra e mede o formato, isto é, se a cabeça é mais alongada ou mais larga. O tamanho da cabeça dos irmãos é bem parecido, com correlação 0.75, e o formato, bem menos, com 0.25.
A primeira correlação dá para conferir sem calcular autovalor nenhum. A soma das duas medidas de cada filho tem variância \(2(1 + 0.60) = 3.2\), e a covariância entre as somas dos dois irmãos é a soma dos quatro elementos do bloco cruzado, 2.4. A correlação é \(2.4/3.2 = 0.75\).
7.2 Interpretação
Os coeficientes definem as variáveis canônicas, mas costumam ser ruins de ler. Eles dependem da escala das variáveis e, quando as variáveis de um bloco são correlacionadas entre si, dividem o efeito entre elas de forma instável, como os coeficientes de uma regressão com multicolinearidade. Um coeficiente pode até ter o sinal oposto ao da relação entre a variável e a variável canônica.
A leitura costuma ser feita pelas cargas canônicas, as correlações entre cada variável e a variável canônica do seu próprio bloco. Como a covariância entre o primeiro bloco e \(U_k\) é \(\boldsymbol{\Sigma}_{11}\boldsymbol{a}_k\) e \(U_k\) tem variância 1, com variáveis padronizadas os vetores de cargas do \(k\)-ésimo par são
As cargas cruzadas são as correlações de cada variável com a variável canônica do outro bloco, e não pedem conta nova. A primeira equação de Equação 7.1 diz que \(\boldsymbol{\Sigma}_{12}\boldsymbol{b}_k = \rho_k\boldsymbol{\Sigma}_{11}\boldsymbol{a}_k\), e portanto a carga cruzada é a carga do próprio bloco multiplicada pela correlação canônica,
Uma correlação canônica alta diz que as duas variáveis do par andam juntas, mas não diz quanto da variação das variáveis originais passa por elas. Se \(U_k\) resume mal o seu bloco, uma correlação alta com \(V_k\) interessa pouco. A variância extraída por \(U_k\) é a média das cargas ao quadrado e mede a fração da variância total do primeiro bloco, já padronizado, que \(U_k\) reproduz. O índice de redundância faz a mesma conta com as cargas cruzadas e mede a fração explicada pela variável canônica do outro bloco,
Para o segundo bloco, as fórmulas são as mesmas, com as cargas do segundo bloco e \(q\) no lugar de \(p\). No bloco menor, as variáveis canônicas reconstituem o bloco inteiro, e as variâncias extraídas somam 1. As redundâncias, ao contrário das correlações canônicas, não são simétricas, e um bloco pode explicar boa parte do outro sem que o contrário aconteça.
Exemplo 7.2 Voltando aos irmãos do Exemplo 7.1, as cargas do primeiro filho nos dois pares são
Comprimento e largura carregam igualmente no primeiro par, o que confirma a leitura de tamanho, e com sinais opostos no segundo, a leitura de formato. Multiplicando pelas correlações canônicas, as cargas cruzadas ficam em 0.671 e 0.112, em módulo.
As variâncias extraídas são \(0.894^2 = 0.8\) no primeiro par e \(0.447^2 = 0.2\) no segundo, e somam 1. As redundâncias são
O tamanho da cabeça do segundo filho explica 45% da variância das medidas do primeiro, e o formato quase nada. Como os dois blocos têm a mesma estrutura, os números do segundo filho são iguais.
7.3 Inferência
Na prática, trocamos \(\boldsymbol{\Sigma}\) pela matriz de covariâncias amostral, ou pela matriz de correlações, e resolvemos a Equação 7.2 com as matrizes amostrais. As correlações canônicas amostrais tendem a exagerar a associação, porque a maximização também aproveita o ruído da amostra. O exagero cresce com o número de variáveis e diminui com o tamanho da amostra, e por isso vale testar quais correlações canônicas diferem de zero antes de interpretá-las.
Supondo normalidade multivariada (Capítulo 3), a independência entre os blocos equivale a todas as correlações canônicas serem nulas e pode ser testada pela razão de verossimilhanças. De forma mais geral, para saber se sobra associação depois dos \(k\) primeiros pares, testamos se as correlações canônicas restantes são nulas com o \(\Lambda\) de Wilks e a estatística corrigida de Bartlett,
que segue aproximadamente uma distribuição \(\chi^2\) com \((p - k)(q - k)\) graus de liberdade. O caso \(k = 0\) é o teste global de independência. Os testes são feitos em sequência, e retemos os pares até o primeiro teste que não rejeita. Com amostras grandes, correlações pequenas demais para interessar acabam significativas, e o teste deve ser lido junto com as redundâncias.
Se as variáveis de um bloco forem quase colineares, a matriz de covariâncias desse bloco fica perto de singular, a inversa da raiz quadrada amplifica o ruído e os coeficientes variam muito de uma amostra para outra. O mesmo acontece quando o número de variáveis se aproxima do tamanho da amostra. As cargas sofrem bem menos com isso, mais um motivo para interpretá-las no lugar dos coeficientes.
Exemplo 7.3 Suponha que as correlações do Exemplo 7.1 tenham vindo de uma amostra de 25 famílias. O fator de correção da Equação 7.3 vale \(25 - 1 - 5/2 = 21.5\). No teste global,
com 1 grau de liberdade e p-valor de 0.24. Com 25 famílias, só a semelhança de tamanho entre irmãos se distingue do ruído.
7.4 Exemplo prático
Exemplo 7.4 (Bico e corpo dos pinguins) No Exemplo 4.6, a ACP tratou as quatro medidas dos pinguins como um bloco só. Agora vamos separá-las em dois blocos, as medidas do bico (comprimento e profundidade) e as do corpo (comprimento da nadadeira e massa corporal), e perguntar como o formato do bico acompanha o tamanho do corpo. Os dados e o tratamento dos valores ausentes são os mesmos da ACP.
Código
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom scipy import linalg, statsnomes = {"bill_length_mm": "Comp. do bico","bill_depth_mm": "Prof. do bico","flipper_length_mm": "Comp. da nadadeira","body_mass_g": "Massa corporal",}bico = ["Comp. do bico", "Prof. do bico"]corpo = ["Comp. da nadadeira", "Massa corporal"]pinguins = pd.read_csv("dados/penguins.csv")pinguins = pinguins.dropna(subset=list(nomes) + ["species"])dados = pinguins[list(nomes)].rename(columns=nomes)R = dados.corr()R.round(2)
Tabela 7.1: Matriz de correlações das medidas dos pinguins. As duas primeiras variáveis formam o bloco do bico, e as duas últimas, o bloco do corpo.
Comp. do bico
Prof. do bico
Comp. da nadadeira
Massa corporal
Comp. do bico
1.00
-0.24
0.66
0.60
Prof. do bico
-0.24
1.00
-0.58
-0.47
Comp. da nadadeira
0.66
-0.58
1.00
0.87
Massa corporal
0.60
-0.47
0.87
1.00
As correlações cruzadas, no canto superior direito da Tabela 7.1, já contam boa parte da história. O comprimento do bico cresce com o tamanho do corpo, e a profundidade diminui. Dentro do bloco do corpo, nadadeira e massa têm correlação 0.87, de modo que esse bloco é quase unidimensional.
Para calcular as correlações canônicas, fazemos a SVD da matriz \(\boldsymbol{K}\) com a matriz de correlações e testamos os pares com a Equação 7.3.
Código
def acc(R, p):"""Correlações canônicas e coeficientes a partir de uma matriz de correlações.""" R11, R12, R22 = R[:p, :p], R[:p, p:], R[p:, p:] R11_inv_raiz = linalg.fractional_matrix_power(R11, -0.5) R22_inv_raiz = linalg.fractional_matrix_power(R22, -0.5) G, rho, Ht = np.linalg.svd(R11_inv_raiz @ R12 @ R22_inv_raiz) A = R11_inv_raiz @ G B = R22_inv_raiz @ Ht.T[:, :p]return rho, A, Bdef testes_bartlett(rho, n, p, q): fator = n -1- (p + q +1) /2 linhas = []for k inrange(len(rho)): lambda_k = np.prod(1- rho[k:] **2) estatistica =-fator * np.log(lambda_k) gl = (p - k) * (q - k) linhas.append([rho[k], lambda_k, estatistica, gl, stats.chi2.sf(estatistica, gl)])return pd.DataFrame( linhas, columns=["Correlação canônica", "Λ de Wilks", "Estatística", "gl", "p-valor"], index=[f"Par {k +1}"for k inrange(len(rho))], )n, p, q =len(dados), len(bico), len(corpo)R11, R22 = R.loc[bico, bico].to_numpy(), R.loc[corpo, corpo].to_numpy()rho, A, B = acc(R.to_numpy(), p)# O sinal de cada par é arbitrário. Escolhemos o sentido em que V cresce# com o comprimento da nadadeira, trocando a e b juntos.sinais = np.sign((R22 @ B)[0])A, B = A * sinais, B * sinaistestes = testes_bartlett(rho, n, p, q)tabela_testes = testes.round(3)tabela_testes["p-valor"] = testes["p-valor"].map(lambda v: f"{v:.2g}")tabela_testes
Tabela 7.2: Correlações canônicas e testes sequenciais de Bartlett. A linha de cada par testa se ele e os seguintes têm correlação canônica nula.
Correlação canônica
Λ de Wilks
Estatística
gl
p-valor
Par 1
0.791
0.37
336.355
4
1.5e-71
Par 2
0.100
0.99
3.409
1
0.065
A primeira correlação canônica vale 0.79 e a segunda, 0.10. O teste global rejeita com folga a independência entre os blocos, e o teste do segundo par tem p-valor 0.065, que não rejeita a 5%. Mesmo que rejeitasse, uma correlação de 0.10 descreve uma associação pequena demais para interessar, e a análise fica com um par só.
Tabela 7.3: Cargas canônicas (correlação com a variável canônica do próprio bloco) e cargas cruzadas (correlação com a do outro bloco) no primeiro par.
Carga
Carga cruzada
Comp. do bico
0.828
0.656
Prof. do bico
-0.739
-0.585
Comp. da nadadeira
1.000
0.791
Massa corporal
0.865
0.684
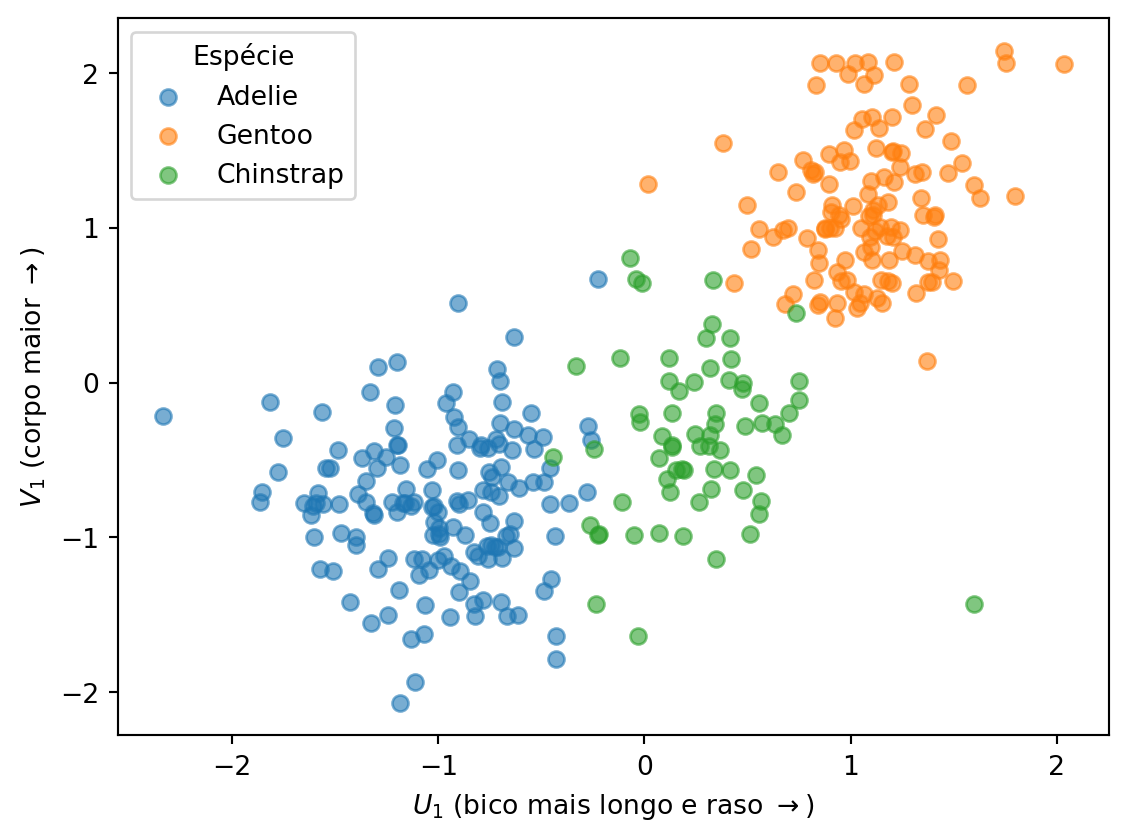
No bloco do corpo, as duas cargas são altas e positivas, e \(V_1\) é simplesmente o tamanho do pinguim. No bloco do bico, o comprimento carrega positivamente e a profundidade negativamente, e \(U_1\) opõe bicos longos e rasos a bicos curtos e profundos. A correlação de 0.79 diz que pinguins maiores tendem a ter bicos longos e rasos.
Pelas redundâncias, o tamanho do corpo, \(V_1\), explica 39% da variância das medidas do bico, e o formato do bico, \(U_1\), explica 55% da variância das medidas do corpo. A assimetria vem da variância extraída, já que \(V_1\) reproduz 87% do bloco do corpo, quase unidimensional, enquanto \(U_1\) reproduz 62% do bloco do bico.
Código
Z = ((dados - dados.mean()) / dados.std()).to_numpy()U = Z[:, :p] @ AV = Z[:, p:] @ Bfig, ax = plt.subplots(figsize=(6, 4.5))for especie in pinguins["species"].unique(): grupo = pinguins["species"].eq(especie).to_numpy() ax.scatter(U[grupo, 0], V[grupo, 0], alpha=0.6, label=especie)ax.set( xlabel=r"$U_1$(bico mais longo e raso $\rightarrow$)", ylabel=r"$V_1$(corpo maior $\rightarrow$)",)ax.legend(title="Espécie")plt.tight_layout()plt.show()
Figura 7.1: Escores do primeiro par de variáveis canônicas, com os pinguins coloridos por espécie.
A Figura 7.1 mostra de onde vem boa parte dessa correlação. Os Gentoo ocupam o canto superior direito, com corpo grande e bico longo e raso, e os Adelie ficam no canto oposto. Os Chinstrap, de bico longo e profundo, ficam no meio do eixo de \(U_1\), com o corpo pequeno, mais perto dos Adelie em \(V_1\). As espécies se separam ao longo da diagonal, e resta saber se a relação se mantém dentro de cada uma.
Código
por_especie = {}for especie, grupo in dados.groupby(pinguins["species"]): R_grupo = grupo.corr().to_numpy() rho_grupo, A_grupo, B_grupo = acc(R_grupo, p) cargas_grupo = np.r_[ R_grupo[:p, :p] @ A_grupo[:, 0], R_grupo[p:, p:] @ B_grupo[:, 0], ]# Mesmo critério de sinal da análise conjunta. cargas_grupo *= np.sign(cargas_grupo[2]) por_especie[especie] = [rho_grupo[0], *cargas_grupo]pd.DataFrame(por_especie, index=["Correlação canônica"] + bico + corpo).round(2)
Tabela 7.4: Primeira correlação canônica e cargas do primeiro par, calculadas separadamente em cada espécie.
Adelie
Chinstrap
Gentoo
Correlação canônica
0.68
0.67
0.83
Comp. do bico
0.82
0.81
0.87
Prof. do bico
0.85
0.97
0.94
Comp. da nadadeira
0.56
0.88
0.92
Massa corporal
0.99
0.93
0.93
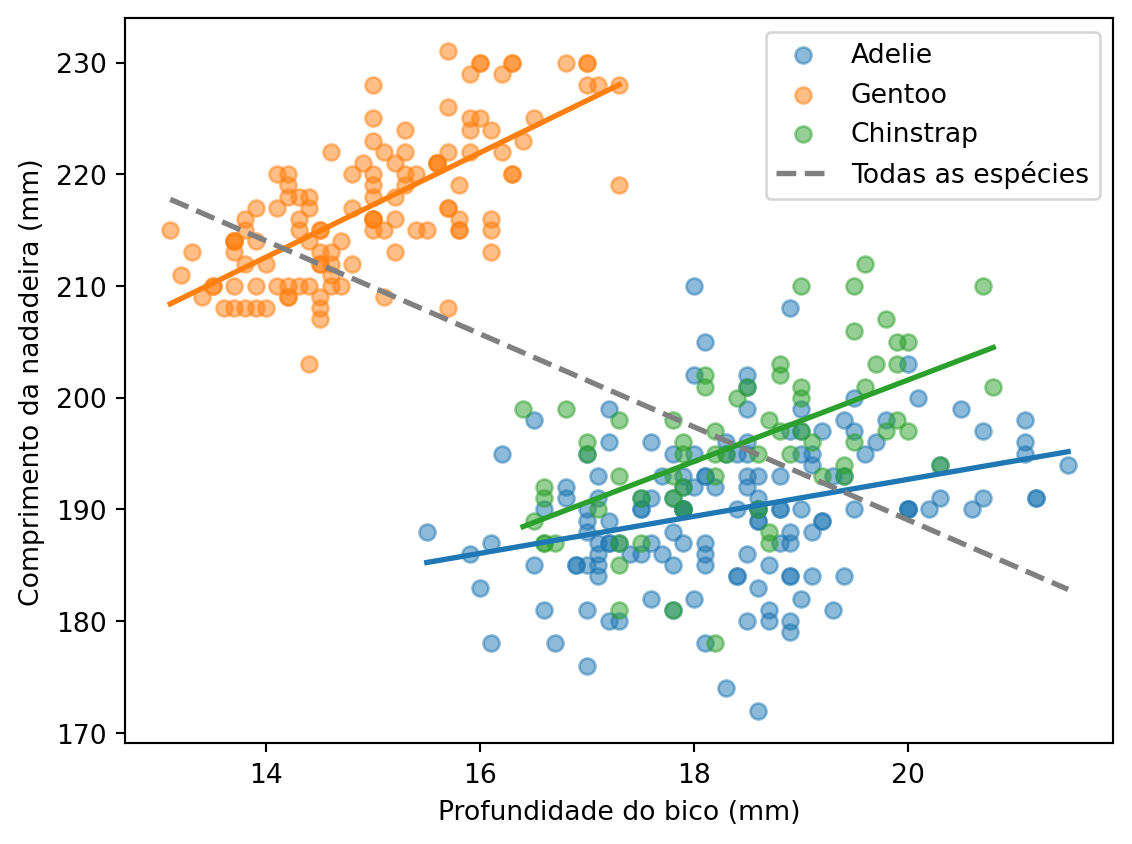
Em todas as espécies a primeira correlação canônica continua alta, mas a profundidade do bico passa a carregar positivamente, junto com o comprimento. Dentro de uma espécie, pinguins maiores têm bicos maiores em todas as direções, como se espera de um animal que cresce por inteiro. O contraste da análise conjunta aparece porque os Gentoo, a espécie de corpo maior, têm os bicos mais rasos.
Código
x_nome, y_nome ="Prof. do bico", "Comp. da nadadeira"fig, ax = plt.subplots(figsize=(6, 4.5))for especie in pinguins["species"].unique(): grupo = pinguins["species"].eq(especie).to_numpy() x, y = dados.loc[grupo, x_nome], dados.loc[grupo, y_nome] pontos = ax.scatter(x, y, alpha=0.5, label=especie) inclinacao, intercepto = np.polyfit(x, y, 1) xs = np.array([x.min(), x.max()]) ax.plot(xs, intercepto + inclinacao * xs, color=pontos.get_facecolor()[0][:3], linewidth=2)inclinacao, intercepto = np.polyfit(dados[x_nome], dados[y_nome], 1)xs = np.array([dados[x_nome].min(), dados[x_nome].max()])ax.plot(xs, intercepto + inclinacao * xs, color="gray", linestyle="--", linewidth=2, label="Todas as espécies")ax.set(xlabel="Profundidade do bico (mm)", ylabel="Comprimento da nadadeira (mm)")ax.legend()plt.tight_layout()plt.show()
Figura 7.2: Profundidade do bico e comprimento da nadadeira. As retas coloridas são ajustadas dentro de cada espécie, e a tracejada, com todas as espécies juntas.
A Figura 7.2 mostra o mesmo efeito numa só dupla de variáveis. A correlação entre a profundidade do bico e o comprimento da nadadeira é negativa com as espécies juntas e positiva dentro de cada uma, um caso do paradoxo de Simpson. Sempre que a amostra mistura grupos, as variáveis canônicas podem descrever as diferenças entre os grupos, e não a relação dentro deles. Se a pergunta é biológica, sobre como o bico acompanha o corpo num mesmo animal, a análise por espécie responde melhor do que a conjunta.
7.5 Exercícios
Exercício 7.1 Mostre que, quando o primeiro bloco tem uma única variável \(X_1\), a única correlação canônica é a correlação múltipla entre \(X_1\) e o segundo bloco, isto é,
que é o coeficiente de determinação da regressão linear de \(X_1\) nas variáveis do segundo bloco. Por que a matriz \(\boldsymbol{K}\) tem um único valor singular nesse caso?
Exercício 7.2 Sejam \(\boldsymbol{C}_1\) e \(\boldsymbol{C}_2\) matrizes inversíveis e considere os novos blocos \(\boldsymbol{C}_1\boldsymbol{x}^{(1)}\) e \(\boldsymbol{C}_2\boldsymbol{x}^{(2)}\).
a) Mostre que as correlações canônicas não mudam. Toda combinação linear dos novos blocos é também uma combinação linear dos antigos.
b) Determine os coeficientes nos novos blocos que reproduzem as variáveis canônicas originais.
c) Conclua que fazer a ACC com a matriz de covariâncias ou com a matriz de correlações leva às mesmas correlações canônicas.
Exercício 7.3 Numa ACC com três variáveis padronizadas no primeiro bloco e quatro no segundo, a primeira correlação canônica é 0.9, e as cargas das variáveis do primeiro bloco em \(U_1\) são 0.35, 0.20 e \(-0.25\).
a) Calcule as cargas cruzadas, a variância extraída e o índice de redundância do primeiro bloco no primeiro par.
b) Um colega conclui, pela correlação canônica, que o segundo bloco explica bem o primeiro. Você concorda?
c) Como duas combinações lineares podem ter correlação tão alta e, ao mesmo tempo, dizer tão pouco sobre as variáveis originais?
Exercício 7.4 (Exercícios físicos e medidas corporais) O conjunto Linnerud, carregado no Python pela função load_linnerud do módulo sklearn.datasets, traz dados de 20 homens de meia-idade atendidos numa academia. Para cada um, foram registrados três exercícios, o número de barras (Chins), de abdominais (Situps) e de saltos (Jumps), e três medidas físicas, o peso em libras (Weight), a cintura em polegadas (Waist) e a pulsação em repouso (Pulse).
a) Calcule a matriz de correlações e comente as correlações entre os dois blocos.
b) Obtenha as correlações canônicas e use os testes sequenciais de Bartlett para decidir quantos pares reter.
c) Interprete o primeiro par pelas cargas canônicas e calcule as redundâncias dos dois blocos.
d) Compare a magnitude da primeira correlação canônica com o resultado do teste global. O que o tamanho da amostra tem a ver com isso?